
Если вы, как и многие (адекватные) программисты в РФ, последние месяцы мучились с «клодиком» — искали друзей за границей для подтверждения личности или ходили «кушать вкусняшки» с обладателями зарубежных паспортов, — выдыхайте. Две недели назад мы искали замену Claude Code среди китайцев и Codex, и тогда казалось, что «обычному русскому Ване» и деваться-то особо некуда. Теперь у Google вышла модель, ради которой стоит открыть второй терминал.
18 ноября Google DeepMind выкатила Gemini 4 Neon. Целится она прямо в Claude Opus 5.5 в самом главном для нас сценарии — агентном программировании.
Google тоже умудрилась превратить запуск редактора в урок географии. Россия мимо обоих списков — и для Antigravity, и для Gemini API. Чтобы войти, нужен личный аккаунт Google (не Workspace), подтверждённый возраст 18+ и поддерживаемая страна в профиле — проверить привязку можно через форму смены страны. Из РФ с Antigravity выкручиваются с VPN и иностранным аккаунтом либо через сторонний анлокер от confeden (он снимает региональную блокировку и для обычного российского аккаунта). Зато без цирка с селфи и чужим паспортом, как у Anthropic.
Что за зверь эта Gemini 4 Neon
В линейке Gemini 4 у Google (помимо более ранней Argon) для разработки выделяют три основные роли:
- Gemini 4 Carbon — тяжёлая артиллерия для самых долгих, жирных исследований и сложных проектов.
- Gemini 4 Hydrogen — быстрая и лёгкая модель для повседневной рутины и параллельных подзадач.
- Gemini 4 Neon — «золотая середина», заточенная под реальную разработку: правки по всему репозиторию, рефакторинг, отладку, безопасный код и работу в агентных харнессах.
Ключевые фишки под капотом
- Контекстное окно до 1 млн токенов (через API и AI Studio; внутри самого Antigravity потолок — 512K). В длинных сессиях Antigravity сама сжимает контекст, чтобы модель реже перечитывала одни и те же файлы.
- Четыре уровня рассуждений:
lowдля быстрых мелких правок,medium,high(идёт по умолчанию) иxhighдля самых тяжёлых задач. - Режим Orchestrator (Neon) в Antigravity. Планированием, исследованием кодовой базы и проверкой в нём занимается Neon, а реализацию берут на себя субагенты на быстрой Hydrogen.
- Мультимодальный ввод. На вход можно скармливать текст, картинки, видео и аудио. Ответ модель отдаёт текстом.
Сравнение с Claude Opus 5.5: сухие цифры и исследования
Теперь к замерам. В сводной таблице карточки модели Google Neon впереди в 16 из 18 строк, где есть результаты обеих моделей.
1. Общий интеллект, скорость и агентные рейтинги
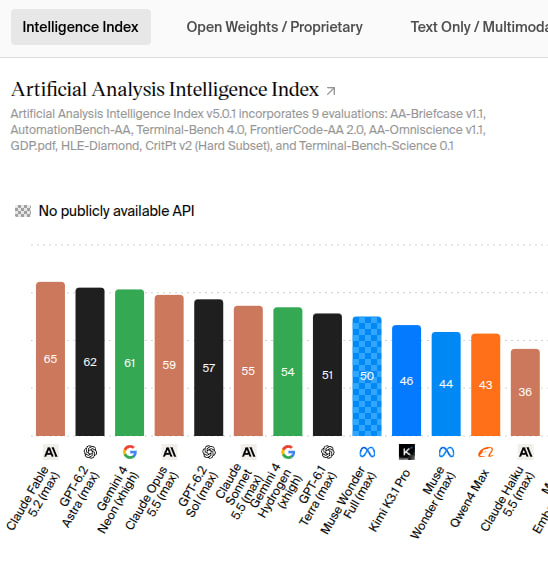
В Artificial Analysis Intelligence Index (v5.0.1) у Neon на xhigh 61 балл, у Opus 5.5 на максимуме — 59 (у Kimi K3.1 Pro, которого мы щупали в начале ноября, — 46). Впереди остаются только топовые флагманы Claude Fable 5.2 (65) и GPT-6.2 Astra (62):
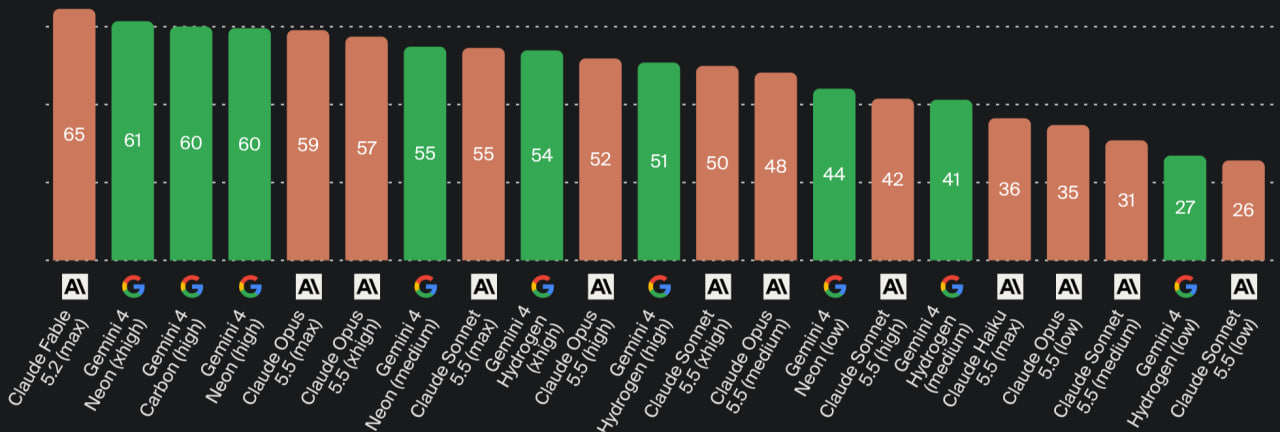
Причём даже на дефолтном high Neon набирает 60 баллов — всё равно на один пункт выше максимального Opus 5.5. По всем уровням рассуждений расклад наглядно выглядит так:
В Coding Agent Index от Artificial Analysis Neon (xhigh) с Antigravity CLI вышла на первое место с оценкой 58,6 (округлённо 59) против 58 у Opus 5.5 (max) с Claude Code.
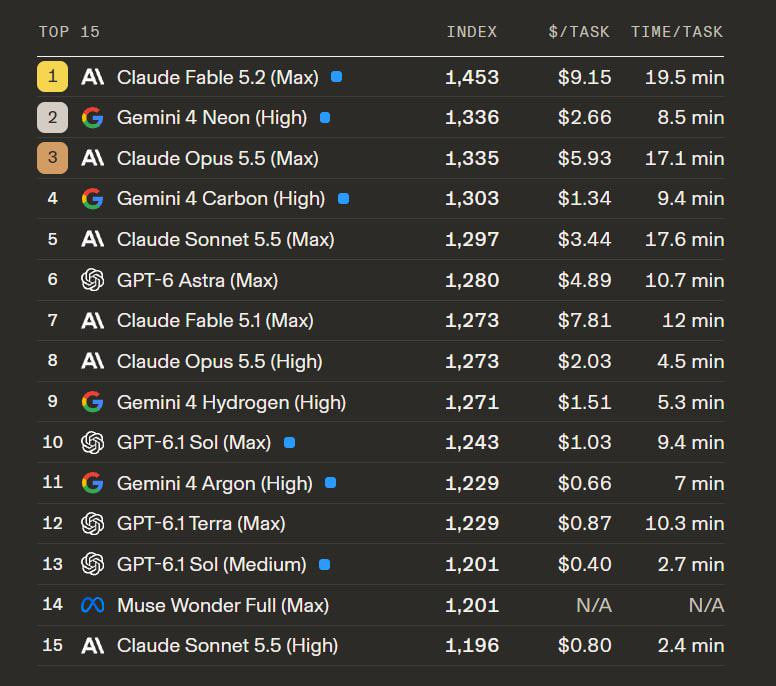
Ещё показательнее таблица Agent Arena (TOP 15 на реальных агентных сессиях): здесь Gemini 4 Neon (High) обошла Opus 5.5 (Max) по индексу (1336 против 1335) и при этом выполнила задачи вдвое быстрее — 8,5 минут против 17,1 минут:
2. Кодинг, безопасность и терминал
- В CursorBench 4.1, где задачи охватывают сразу несколько файлов в реальных сессиях, отрыв заметный: у Neon 65,4%, у Opus 5.5 — 58,1%.
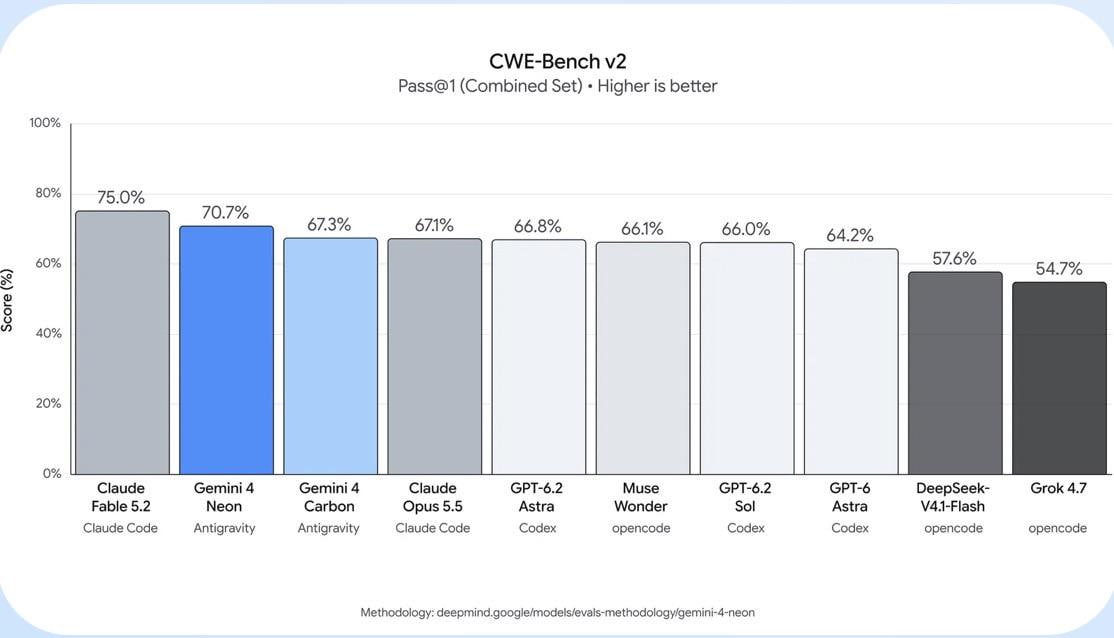
- В исправлении уязвимостей (CWE-Bench v2) связка Neon + Antigravity набрала 70,7% против 67,1% у Opus 5.5 в Claude Code:
- В Terminal-Bench 4.1 у Opus 5.5 65,8%, у Neon — 65,2% (разница всего 0,6 процентного пункта). В FrontierCode 2.0 у Opus 47,3%, у Neon — 46,2%, но стоит учесть, что в таблице Google для FrontierCode брали прогон Neon на дефолтном
high, а не на максимальномxhigh.
Разрыв в терминале и сложном кодинге по сути на уровне погрешности. Показательные 3D-демки из анонса Google (вроде симулятора фрирайда на Монблане на WebGL2 или 3D-кабинета Тьюринга через Blender MCP) смотрятся красиво, но на практике куда важнее то, как модель переваривает реальный репозиторий с тестами, миграциями и легаси.
3. Что даёт харнесс
В SWE-sweep агенту дают целый репозиторий без подсказок и просят найти и починить баги. По замерам Google одна и та же Neon на простом Mini-SWE исправила 12,8% багов, а в Antigravity CLI — уже 39,0%. Для сравнения: у Opus 5.5 в той же таблице 3,6% на Mini-SWE и 10,1% в Claude Code.
Секрет прост: в Antigravity агент по умолчанию умеет раскидывать поиск по кодовой базе на параллельных субагентов. Так что смотреть на сухие баллы модели в отрыве от харнесса уже бессмысленно.
Итог
Gemini 4 Neon уже стоит пробовать на тех задачах, ради которых вы терпели Claude Code. По общему индексу, скорости работы и многофайловым правкам она уже впереди, а проблемы с региональными ограничениями решаются проще.
У Opus остаётся перевес в 0,6 процентного пункта в терминале. Если ради этих 0,6 п.п. нужно тратить вечер на поиск друзей с подходящими документами и гадать, когда прилетит очередной бан, мне плевать на этот перевес. Инструмент должен экономить время, а не превращать сам доступ к нему в отдельную работу.
Комментарии (2)